Skip to content

数理统计与估计:数据是随机的,估计量是数据的函数 ​

WARNING

🧪 Beta公测版本提示:教程主体已完成,正在优化细节,欢迎大家提Issue反馈问题或建议。

概率论假定 p、μ 已知,问样本会长什么样。数理统计反过来:样本已经落在桌上,问参数大概是多少。本章只抓三件:点估计、极大似然、偏差(除以 n 还是 n−1)。前置:常见分布。区间与「平均为何像高斯」见 CLT。贝叶斯把参数也当成随机变量,仍在 概率与贝叶斯。


一、样本与估计量 ​

X1,…,Xn i.i.d. 来自某个带参数 θ 的分布。估计量 θ^=g(X1,…,Xn) 是样本的函数,所以它自己也是随机变量。同一组硬币,再抛一次,p^ 会变。

常见无脑但好用的选择:

  • 样本均值 X¯=1n∑Xi 估期望;
  • 样本方差 s2=1n−1∑(Xi−X¯)2 估方差。

无偏:E[θ^]=θ。无偏说的是「重复实验,估计量的平均瞄得准」,不说「这一次就准」。除以 n−1 就是为了让 s2 无偏——用 X¯ 代替了未知的 μ,少了一个自由度。

极大似然

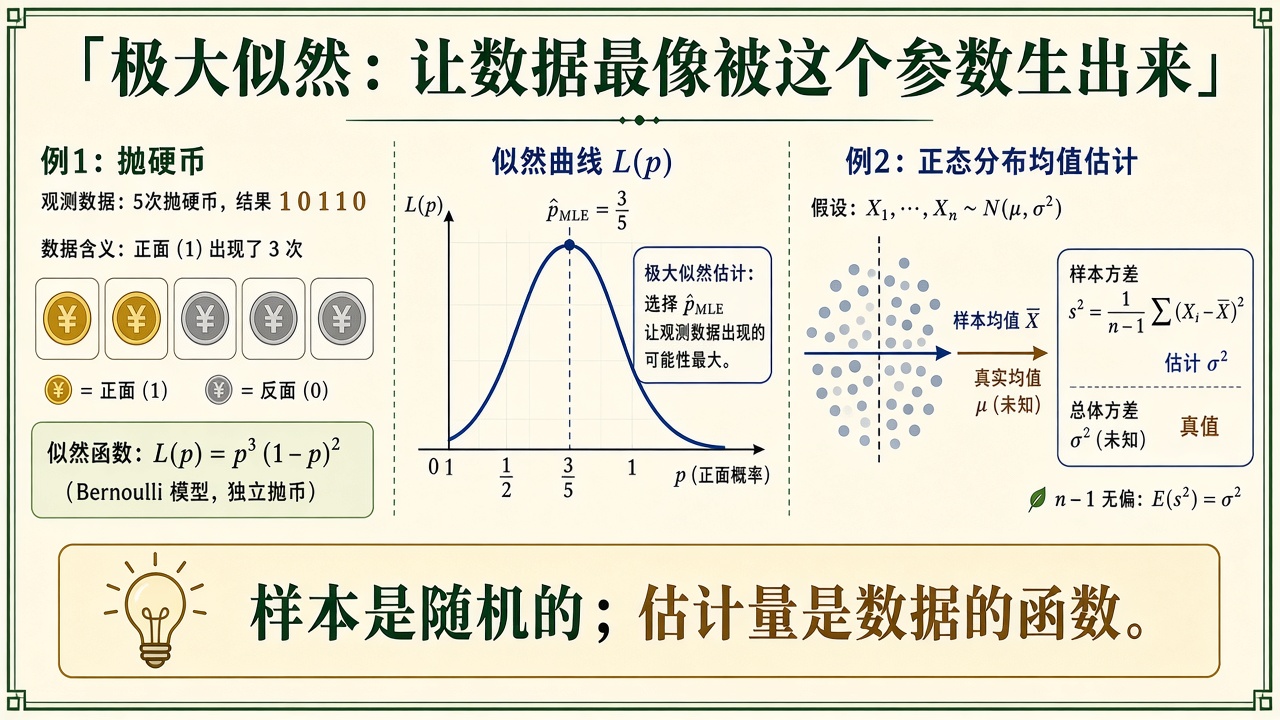
图解说明:左是数据;中是似然山峰,p^MLE 在山顶;右是高斯云里样本均值对准 μ,并标出 n−1。底栏:估计量随数据抖。

保姆级数字例。 demo 硬编码的十次抛币

{1,0,1,1,0,1,1,1,0,1}

七个正面,伯努利 MLE p^=7/10=0.7。C++ mle.hpp 印的就是这个数。它等于样本均值:对 0/1 数据,X¯ 就是正面比例。

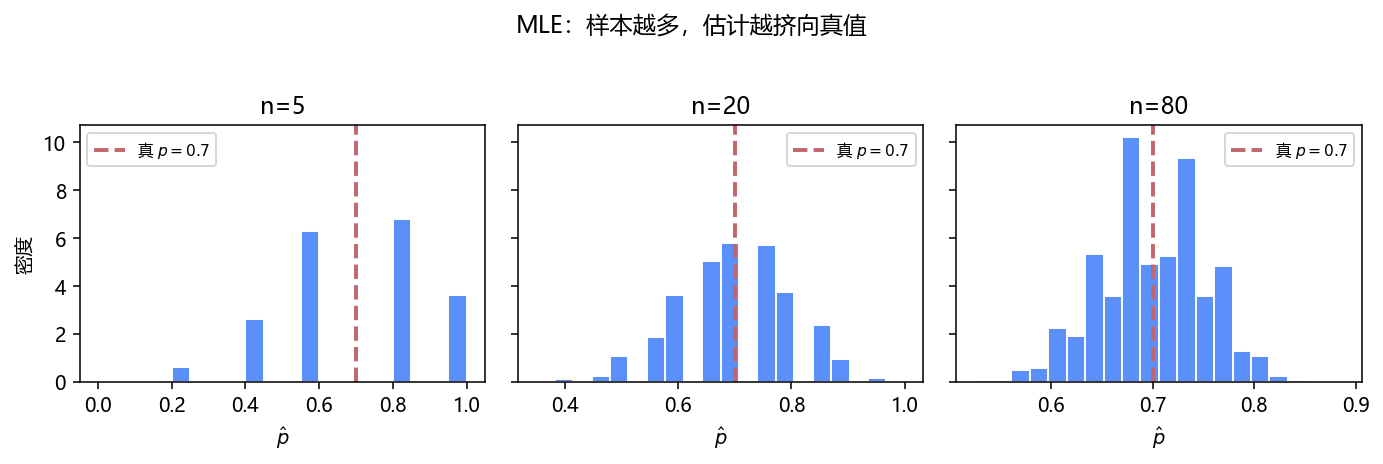
同一颗硬币若真 p=0.7,把「抛 n 次再算 p^」重复 2000 遍,会得到一堆 p^。demo 左三张直方图:n=5,20,80。n 越大,直方图越挤向 0.7——这是 LLN,还不是 CLT 的铃铛形状。

卡点。 「无偏」不是「最好」。MLE 方差估计除以 n,略偏小,但均方误差有时反而更小(偏差的平方被方差的下降抵掉)。工程上报告样本方差时习惯无偏 n−1;训练神经网络拟合高斯噪声时,实现里经常直接 mean((x-mu)**2),那是 MLE。两套惯例并存,读代码先看分母。


二、极大似然 ​

似然把参数当变量、数据当常数:

L(θ)=∏i=1nf(xi∣θ).

θ^MLE=arg⁡maxθL(θ)(通常对 log⁡L 求导更稳:乘积变求和,避免下溢)。

  • 伯努利:L(p)=pk(1−p)n−k,k 次正面 ⇒p^=k/n=X¯。
  • 高斯(μ,σ2 都未知):μ^=X¯,σ^MLE2=1n∑(Xi−X¯)2。注意 MLE 除以 n,所以对 σ2 有偏(略偏小)。无偏方差才除以 n−1。

平方误差损失对应高斯、固定 σ 时的最大似然——这就是「最小二乘从哪来」的统计说法。分类的交叉熵是另一张脸的 MLE,见 信息论精简。

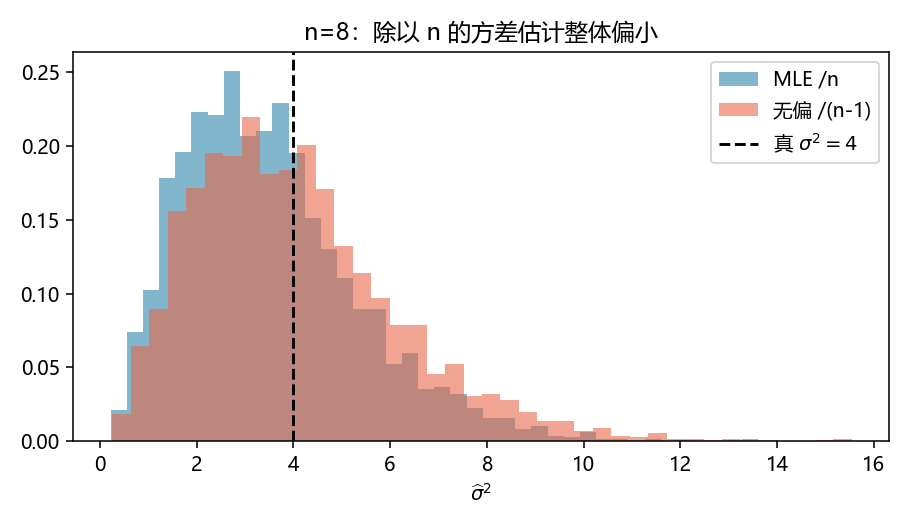
保姆级数字例。 高斯真值 μ=0、σ2=4,每次抽 n=8 个点,重复 4000 次:

估计分母理论期望demo 要对照的现象
σ^MLE2n=8n−1nσ2=78⋅4=3.5直方图整体在 4 左侧
s2 无偏n−1=74中心更正,略更散

3.5 对 4 相对偏差 12.5%——n=8 时已经能在图上看出「蓝堆偏左」。n→∞ 时 (n−1)/n→1,两种分母和解。

逐步推导:伯努利似然的山顶在 k/n(点击展开)

n 次独立抛币,正面 k 次(其余 n−k 次反面)。似然

L(p)=(nk)pk(1−p)n−k,p∈(0,1).

对数(扔掉与 p 无关的组合数)

ℓ(p)=klog⁡p+(n−k)log⁡(1−p).

求导:

ℓ′(p)=kp−n−k1−p.

令导数为 0:k(1−p)=(n−k)p⇒k−kp=np−kp⇒k=np⇒p^=k/n。

二阶导 ℓ″(p)=−k/p2−(n−k)/(1−p)2<0,所以是极大。端点 p=0 或 1:若 0<k<n,似然为 0,不会比内点更大。

代入 demo 的十次:k=7,p^=0.7。若改成先验 Beta(2,2) 再取后验均值,得到 9/14≈0.643(见 概率与贝叶斯)——MAP / 后验均值把答案从 0.7 往 0.5 拽。MLE 等于「平坦先验下的 MAP」。

为什么 n 大时 p^ 变挤。 Var(p^)=Var(X¯)=p(1−p)/n。真 p=0.7 时 p(1−p)=0.21,于是

n=5: σp^≈0.205,n=20: ≈0.102,n=80: ≈0.051.

直方图的宽度大约按 1/n 收——与左三张图一致。形状要到更大的 n 才像高斯,那是下一章 CLT。

逐步推导:为什么除以 n 的方差有偏、除以 n−1 无偏(点击展开)

设 Xi i.i.d.,EXi=μ,Var(Xi)=σ2。样本均值 X¯ 无偏,Var(X¯)=σ2/n。离差平方和

S=∑i=1n(Xi−X¯)2.

关键恒等式(把 μ 加进再减出):

Xi−X¯=(Xi−μ)−(X¯−μ),

平方求和后交叉项抵消,得到

S=∑i(Xi−μ)2−n(X¯−μ)2.

两边取期望:

E[S]=nσ2−n⋅σ2n=(n−1)σ2.

因此

E[Sn]=n−1nσ2<σ2,E[Sn−1]=σ2.

MLE 除以 n,期望是 n−1nσ2。demo 里 n=8、σ2=4,理论 E[σ^MLE2]=3.5。直观:X¯ 比真 μ 更「贴近」样本,用 X¯ 算出来的平方和系统性地偏小,缺的那一截正好是 σ2——所以要除以 n−1 补回来。

高斯情形还可以从似然直接推 MLE。log⁡L 对 μ 求导立刻给出 μ^=X¯;对 σ2 求导给出 σ^2=S/n。无偏修正是事后乘 n/(n−1),不是 MLE 自己的一阶条件。

概率章那个 {1,2,3,4,5}:若当作总体,S=10,10/5=2;若当作样本,10/4=2.5。同一公式,两种世界观。

方差:/n vs /(n-1)

图解说明:n=8、真 σ2=4。蓝色 MLE 堆的中心靠近 3.5;橙色无偏堆的中心靠近 4。黑虚线是真值。


三、代码在做什么 ​

左三张直方图:真 p=0.7,p^ 在 n=5,20,80 时越挤越紧(还没到 CLT 的正规形状,那是下一章)。右:同一批 n=8 的高斯样本,MLE 方差整体比真值 4 偏左,无偏版本中心更正。

伯努利 MLE 随 n

方差:/n vs /(n-1)

C++ mle.hpp 对硬编码的 10 次抛币印 p^=0.7,对 {1,2,3,4,5} 印高斯 MLE(均值 3,方差 2)。

bash
cd docs/math/estimation/code
python demo.py
g++ -std=c++17 demo.cpp -o est_demo

四、小结 ​

概念一句话
估计量数据的函数,本身随机
无偏平均瞄得准;不保证单次准
MLE让当前数据最像被 θ 生出来
n vs n−1MLE 方差偏小,期望是 n−1nσ2;样本方差无偏
下游回归、EM、CLT

下一章 大数定律与中心极限:为什么 n 大时 θ^ 会老实,以及为何误差条常画成高斯。

📥 Code ​

FileViewDownload
demo.pyOpenDownload
mle.hpp—Download
demo.cpp—Download
exercise.pyOpenDownload

参考 ​

  1. Casella & Berger, Statistical Inference
  2. Wasserman, All of Statistics(短而全)