优化与梯度:损失怎么变成更新
WARNING
🧪 Beta公测版本提示:教程主体已完成,正在优化细节,欢迎大家提Issue反馈问题或建议。
训练一个模型 = 选一个损失
,再找让它变小的参数 。本章只讲:梯度是什么、梯度下降怎么走、学习率的坑、链式法则为何等于反向传播。凸优化理论点到为止。链式法则的几何在 导数与微分;损失里的「平均」来自 大数定律;线代前置从 向量 到 特征值。
一、损失曲面与梯度
把参数想成地图上的坐标,损失想成海拔。梯度
:学习率(步长)。太大振荡或发散,太小爬得极慢。 - 一阶方法只看当地坡度,不保证一次走到谷底——深度网络几乎总是非凸的,但 SGD 在实践中够用。
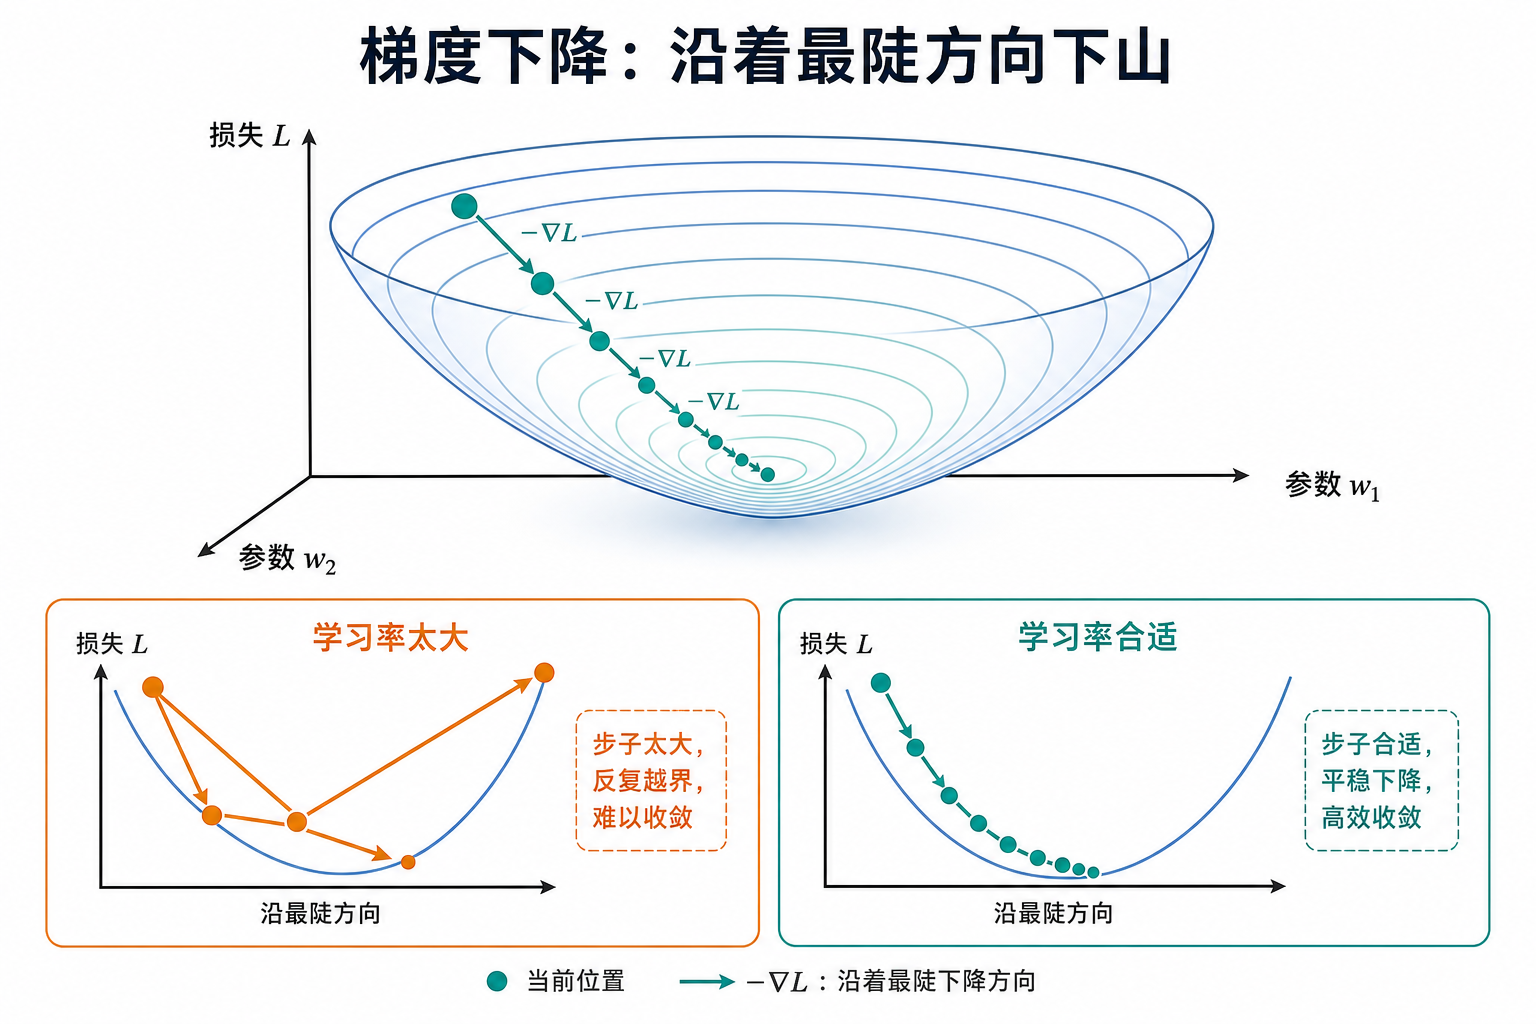
图解说明:等高线谷底是目标;橙色折线是步子过大;平滑轨迹是合适学习率。
动画说明:同一起点。
在谷里振荡; 沿着等高线走进 。
随机梯度下降(SGD):每次只用一个小批量估计
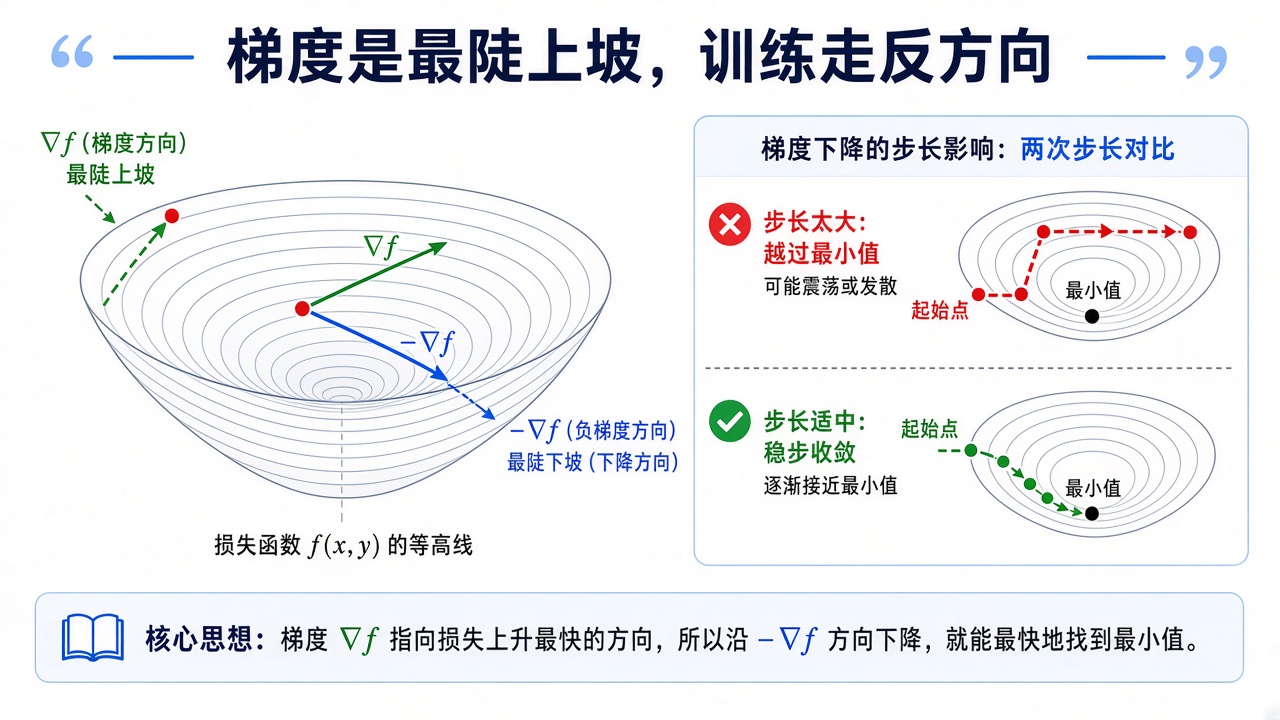
图解说明:等高线碗底。绿箭头
上坡,蓝箭头 下山。步长过大在谷里振荡。
逐步推导:线性回归 MSE 的梯度为什么是
梯度是「与
从误差递推看“振荡”和“发散”的区别。 对正定二次函数
因此所有方向收敛需要
本例
二、常见损失的梯度直觉
| 损失 | 典型用途 | 梯度在说什么 |
|---|---|---|
| MSE | 回归 | 把预测往标签拉 |
| 交叉熵 | 分类 / 语言模型 | 提高正确类概率 |
| Hinge | SVM | 只惩罚间隔不够的点 |
线性回归
这就是「误差反投射回特征」——后面链式法则是同一思想的多层版。
三、链式法则 = 反向传播
复合
神经网络前向算激活,反向把
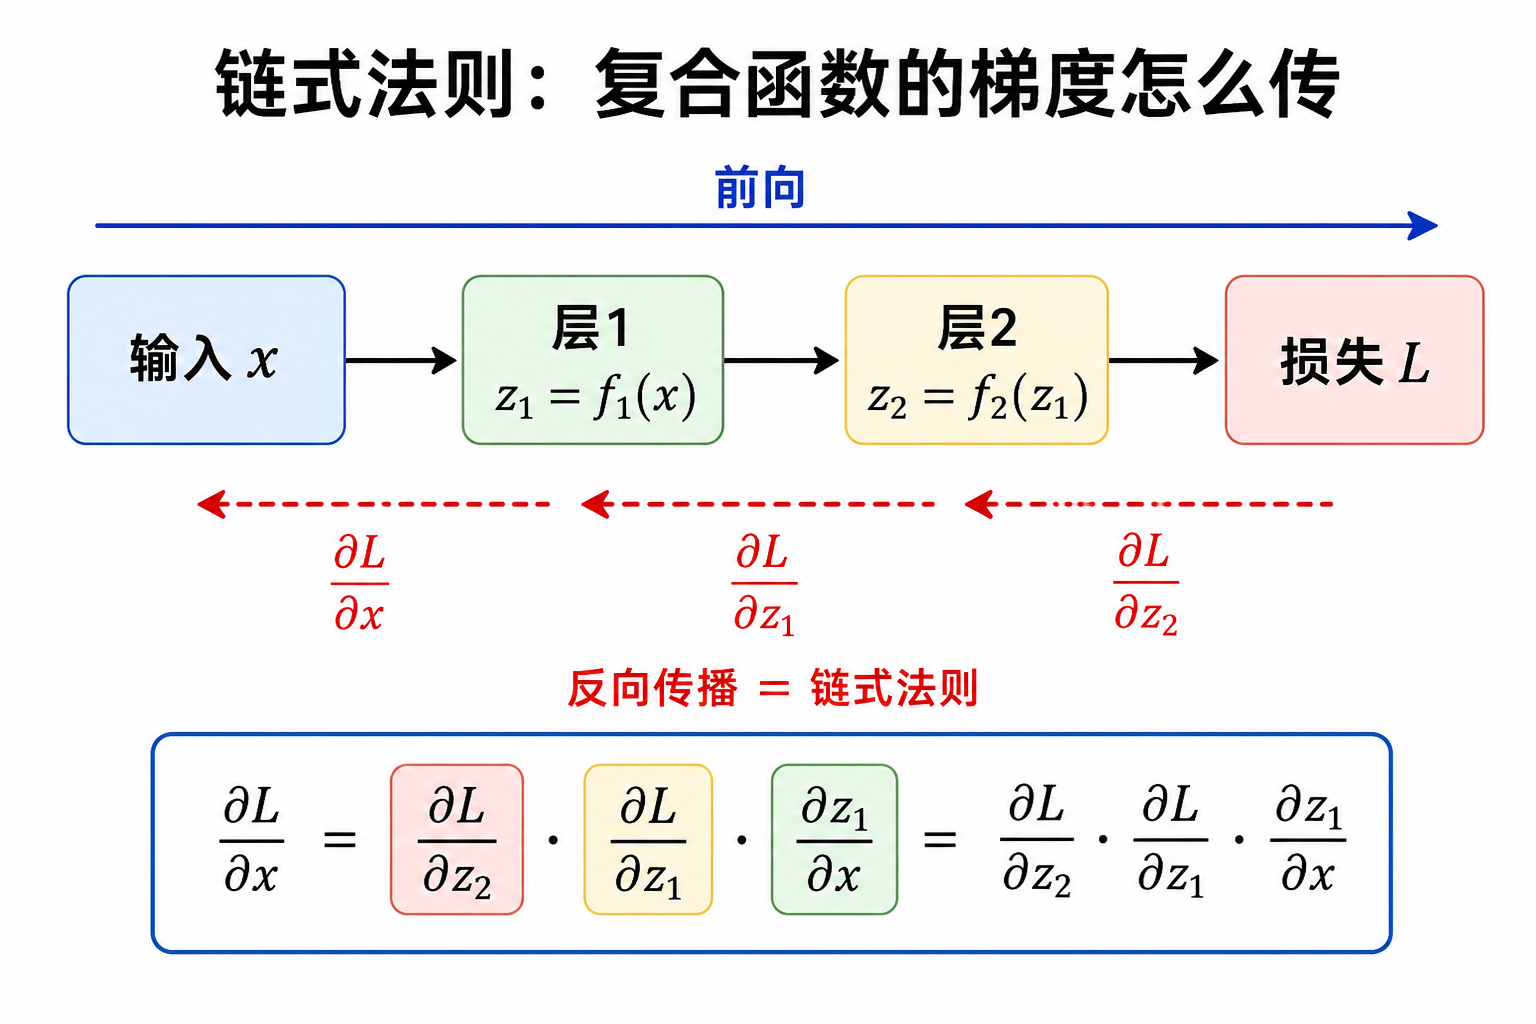
图解说明:上边前向出损失,下边反传梯度。自动求导框架替你记账,但形状与「谁乘谁」要心里有数。
标量链条中局部导数的绝对值若持续大于 1 或小于 1,多层相乘可能爆炸或消失;向量情形还需看雅可比乘积的方向与奇异值——这是深度网络要残差、归一化、合适激活的原因之一。
四、正则与约束(直觉)
只最小化训练损失容易过拟合。常见补丁:
- L2 正则
:把参数往 0 拉,等效「别用太大的权重」; - 早停 / Dropout:优化路径上的工程正则;
- 投影 / 裁剪:梯度爆炸时把更新限制在球内。
世界模型里的 free-bits、KL balancing,也是「别让某一项梯度把表示掐死」的优化经验。
五、代码在做什么
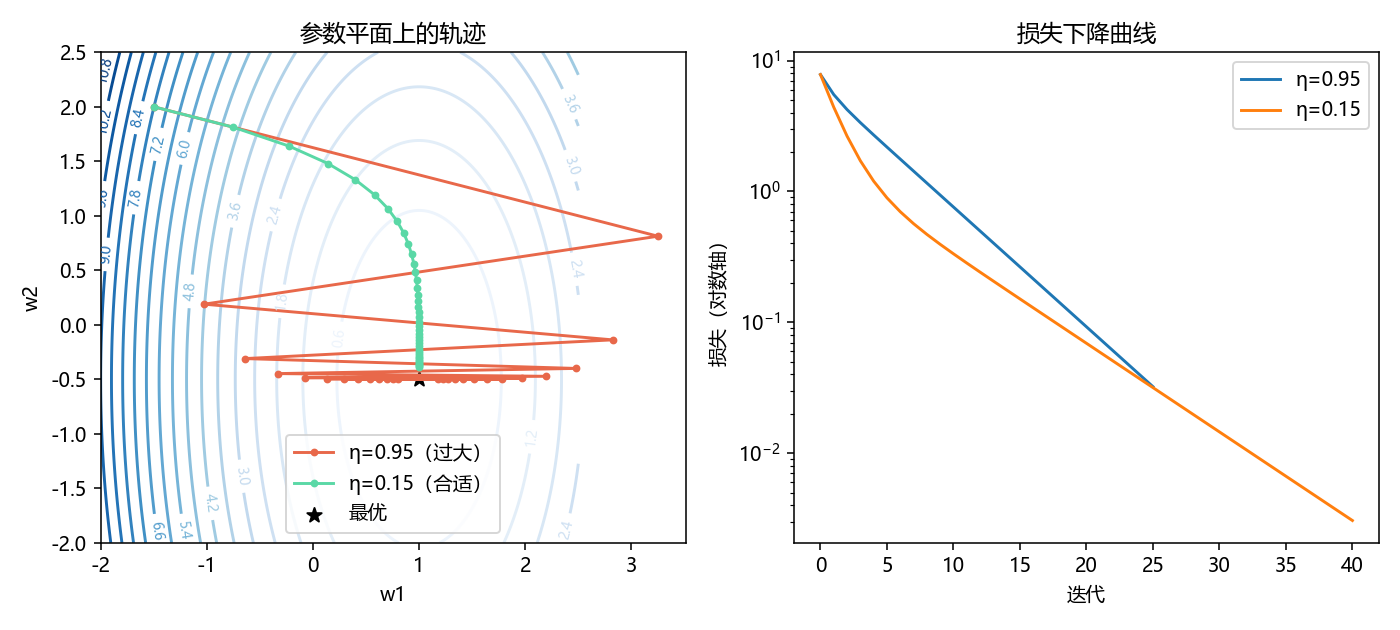
demo.py 在二维碗状损失
六、小结
| 概念 | 一句话 |
|---|---|
| 梯度 | 上升最快方向;训练走负梯度 |
| 学习率 | 步长,太大抖、太小慢 |
| SGD | 用小批量估计梯度 |
| 链式法则 | 复合函数求导;反传的数学本质 |
| 下游 | 所有可训练神经网络与凸/非凸 ML |
📥 Code
| File | View | Download |
|---|---|---|
| demo.py | Open | Download |
| exercise.py | Open | Download |
参考
- Boyd & Vandenberghe, Convex Optimization(选读前几章)
- Nielsen, Neural Networks and Deep Learning(反传推导清晰)