Skip to content

常见分布:计数、等待、噪声各用哪一张脸 ​

WARNING

🧪 Beta公测版本提示:教程主体已完成,正在优化细节,欢迎大家提Issue反馈问题或建议。

上一章用贝叶斯更新信念,但似然 P(data∣θ) 必须先指定「数据长什么样」。本章只放五张最常用的脸:伯努利 / 二项、泊松、指数、高斯,并记住各自的期望与方差。前置:概率与贝叶斯。怎么从样本反推参数,见下一章 估计。


一、同一套数字特征,不同的生成故事 ​

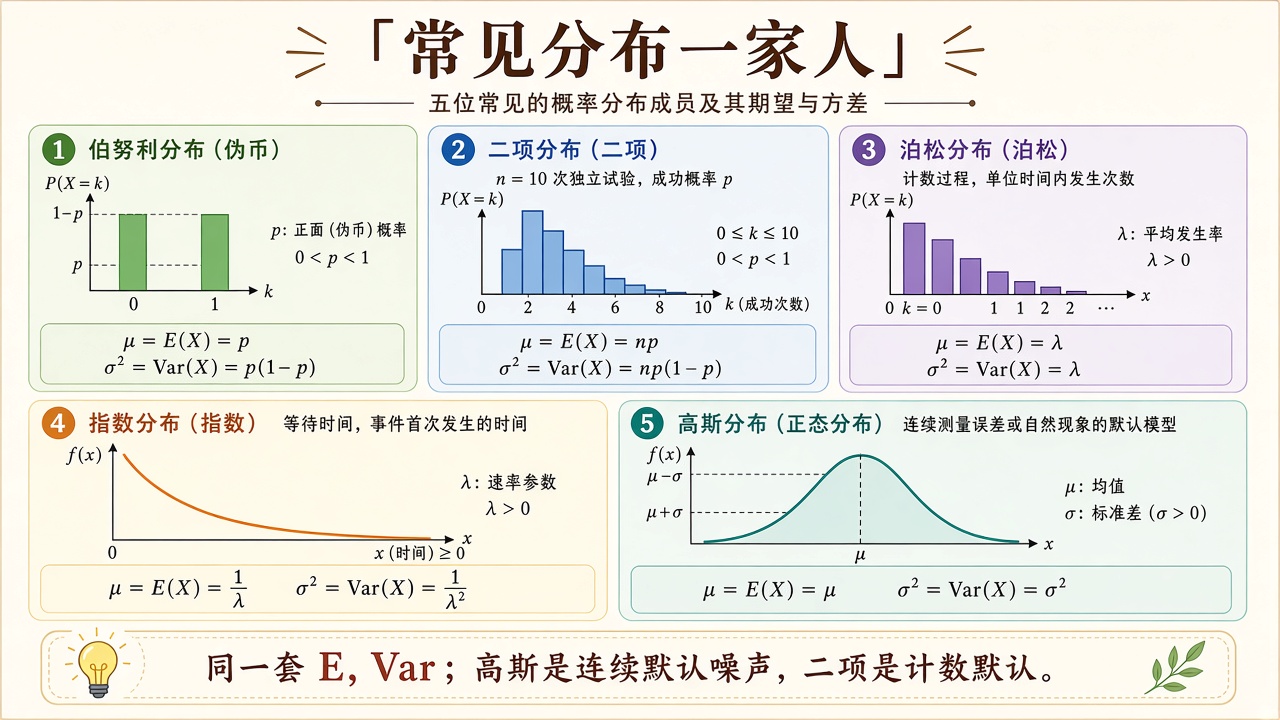
选分布不是看哪条曲线好看,而是问数据怎么生成的。抛一次币、抛 n 次再计数、稀有事件的个数、等到下一辆车、大量微小误差叠加——五张脸对应五种故事。数字特征却是同一套:期望(中心)和方差(分散)。

分布故事EVar
Bernoulli(p)一次抛币pp(1−p)
Binomial(n,p)n 次独立抛币的正面数npnp(1−p)
Poisson(λ)稀有事件的计数λλ
Exp(λ)等到下一事件的时间1/λ1/λ2
N(μ,σ2)大量微小误差叠加μσ2

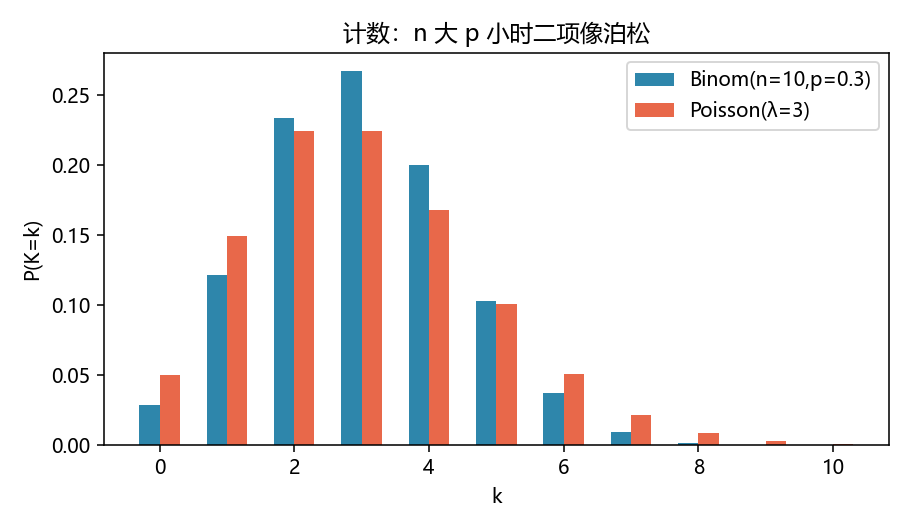
n 大、p 小、np=λ 固定时,二项的 pmf 会贴向泊松——demo 里 n=10,p=0.3,λ=3 已经能看出轮廓像(还没完全贴死:n=10 谈不上「很大」)。指数的无记忆:已经等了 t 秒,再等 s 秒的分布与从头等 s 秒一样。高斯的「默认噪声」地位来自中心极限,详见 CLT。

常见分布一家人

图解说明:左三是离散计数,右二是连续密度。同一套 E,Var;选哪一张脸取决于数据怎么生成,不是看哪条曲线好看。

保姆级数字例。 伯努利 p=0.3:期望 0.3,方差 0.3×0.7=0.21。抛 n=10 次,二项期望 np=3,方差 2.1,标准差 2.1≈1.45——所以 K 多数落在 0 到 6 附近,极端的 K=10 很稀有。泊松 λ=3 期望、方差都是 3,比二项略散一点(二项有「最多 n 次」的硬顶,泊松没有)。

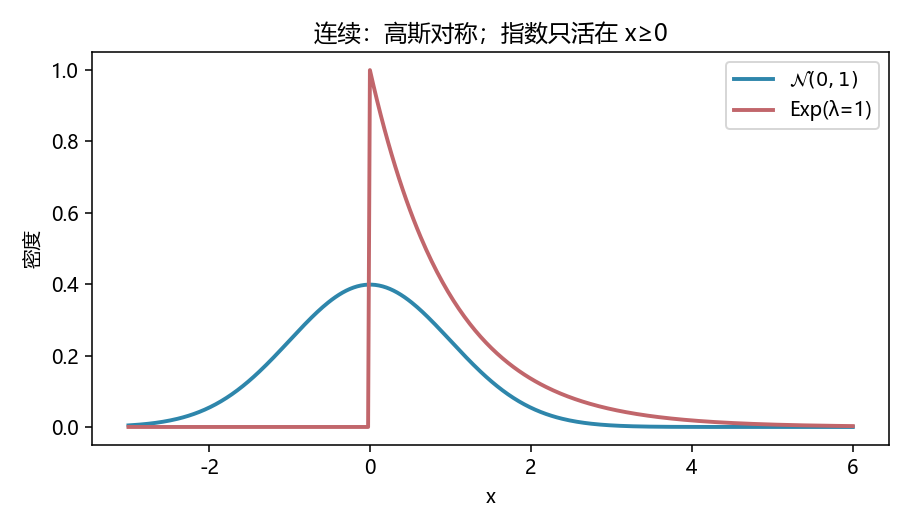
卡点。 泊松「均值=方差」是诊断:若计数数据的样本方差远大于样本均值(过离散),泊松会低估尾部,该换成负二项。指数的「无记忆」对机械寿命往往不成立(零件会老化);它对放射性衰变、理想排队更合适。高斯对称、可取负值:等待时间、降雨量不要直接套高斯。


二、密度公式(代码里就是这几行) ​

二项:

P(K=k)=(nk)pk(1−p)n−k.

泊松(用对数累加避免 k! 爆):

P(K=k)=e−λλkk!.

高斯与指数:

ϕ(x)=12πσexp⁡(−(x−μ)22σ2),f(x)=λe−λx (x≥0).

C++ dist.hpp 与 Python demo.py 打印同一组探针:Binom(10,0.3) 的 P(K=3)、φ(0)≈0.3989。

保姆级数字例(与 demo 探针一致)。

PBinom(K=3)=(103)(0.3)3(0.7)7=120×0.027×0.0823543≈0.2668,PPoisson(K=3)=e−3333!≈0.049787×4.5≈0.2240,ϕ(0)=12π≈0.3989.

二项在 k=3 处比泊松更高一点:因为 n=10 还不够大,p=0.3 也不算很小,泊松极限只是「轮廓像」。标准正态在 0 处的高度 0.3989 是记住「铃铛有多高」的尺子——σ 若改成 2,峰高变成 0.3989/2≈0.1995。

逐步推导:二项如何从 n 次伯努利加出来,以及 P(K=3)≈0.2668(点击展开)

一次伯努利:Xi∈{0,1},P(Xi=1)=p。令 K=X1+⋯+Xn。K=k 意味着某 k 个位置是 1、其余是 0。一种具体序列的概率是 pk(1−p)n−k;这样的序列有 (nk) 种,所以

P(K=k)=(nk)pk(1−p)n−k.

期望用线性(不必独立):EK=nEX1=np。方差用独立可加:Var(K)=np(1−p)。

代入 n=10、p=0.3、k=3:

(103)=10⋅9⋅86=120,0.33=0.027,0.77=0.0823543.

120×0.027=3.24,3.24×0.0823543≈0.2668。这就是终端打印的 Binom P(K=3)。

组合数 (nk) 会溢出:C++ 用乘除交错算 (nk),泊松 pmf 用 log 累加 −λ+klog⁡λ−∑i=2klog⁡i 再 exp,避免先算 k!。Python math.comb 在 n=10 上完全安全。

伯努利方差 p(1−p) 在 p=1/2 最大(=1/4),在 p→0 或 1 时趋于 0——很偏的硬币几乎每次都一样,计数几乎不散。这就是「确定事件熵小」在方差上的影子。

逐步推导:泊松极限 np=λ 与指数无记忆(点击展开)

泊松是二项的稀有事件极限。 令 p=λ/n,固定 k,令 n→∞:

P(K=k)=n(n−1)⋯(n−k+1)k!(λn)k(1−λn)n−k=λkk!⋅nn⋅n−1n⋯n−k+1n⏟→1⋅(1−λn)n⋅(1−λn)−k.

(1−λ/n)n→e−λ,(1−λ/n)−k→1。于是

P(K=k)→e−λλkk!.

demo 用 n=10、p=0.3、λ=3:PBinom(K=3)≈0.2668 对 PPoisson(K=3)≈0.2240,相对差约 19%——轮廓像,定量还早。经验上 n≥50、p≤0.1 才开始「贴」。泊松均值等于方差:EK=Var(K)=λ。

指数来自泊松过程的等待。 若事件按速率 λ 独立发生,则等第一个事件的时间 T 满足 P(T>t)=P(这段里 0 个事件)=e−λt,密度 f(t)=λe−λt(t≥0)。期望 ET=1/λ,方差 1/λ2。λ=1 时密度在 0 处是 1,然后按 e−t 下降;负半轴为 0——这就是右图那条折线。

无记忆。 已经等了 s 秒还没来:

P(T>s+t∣T>s)=P(T>s+t)P(T>s)=e−λ(s+t)e−λs=e−λt=P(T>t).

再等 t 秒的分布,和刚开始等一模一样。几何分布(离散等待)有同样的性质。有老化的寿命模型(Weibull、Γ)会打破它。

高斯在 0 处。 μ=0、σ=1:

ϕ(0)=12π≈12.5066≈0.3989,

与终端 N(0,1) φ(0)=0.3989 一致。积分 ∫−∞∞ϕ=1 需要高斯积分 ∫e−x2/2dx=2π,本章当作已知。大量独立微小误差之和长成这只铃铛,证明见 CLT。

二项与泊松

图解说明:n=10、p=0.3 的二项柱,对 λ=3 的泊松柱。峰都在 k=3 附近,高度和尾巴略有差别。


三、代码在做什么 ​

左:二项柱与泊松柱并排。右:标准正态铃铛对指数折线(指数在负半轴为 0)。

二项与泊松

高斯与指数

bash
cd docs/math/distributions/code
python demo.py
g++ -std=c++17 demo.cpp -o dist_demo

四、小结 ​

概念一句话
伯努利 / 二项抛币与计数;P(K=3)≈0.2668(n=10,p=0.3)
泊松稀有事件;均值=方差;二项的 np=λ 极限
指数等待时间;无记忆;只活在 x≥0
高斯对称噪声;ϕ(0)≈0.3989;平方损失的亲戚
下游似然、GLM、估计

下一章 数理统计与估计:有了生成故事,怎么用数据猜 p、μ、σ2。

📥 Code ​

FileViewDownload
demo.pyOpenDownload
dist.hpp—Download
demo.cpp—Download
exercise.pyOpenDownload

参考 ​

  1. Blitzstein & Hwang, Introduction to Probability
  2. Feller, An Introduction to Probability Theory(经典叙事)